

Load Average در لینوکس میانگین تعداد کارهای در حال اجرا یا آمادهٔ اجرا و برخی کارهای در انتظار غیرقابلوقفه است. این عدد نه زمان لود صفحه بر حسب ثانیه است و نه درصد مصرف CPU. بنابراین نسبت دادن مستقیم Load برابر ۱ به مصرف ۵۰ درصد CPU یک سرور دوهستهای درست نیست.
Load Average در لینوکس را با uptime ببینید
در ترمینال مجاز سرور، دستور خواندنی زیر را اجرا کنید:
uptimeراهنمای uptime سه مقدار را برای بازههای ۱، ۵ و ۱۵ دقیقه توضیح میدهد. در نمونهٔ فرضی زیر، مقدار کوتاهمدت بالاتر است؛ این میتواند نشانهٔ افزایش اخیر بار باشد، اما علت را مشخص نمیکند.
load average: 4.20, 2.10, 1.30تعداد پردازنده را در تفسیر دخالت دهید
برای دیدن واحدهای پردازشی در دسترس فرایند فعلی، دستور زیر مفید است. در کانتینر یا سرویس محدودشده، ظرفیت واقعی تخصیصیافته را نیز از تنظیمات همان محیط بررسی کنید.
nprocطبق مستند nproc، مقدار در دسترس میتواند با تعداد پردازندههای نصبشده متفاوت باشد. اگر بار عمدتاً CPUمحور باشد، مقایسه با ظرفیت به تشخیص صف کمک میکند؛ اما انتظار I/O میتواند Load را بالا ببرد، حتی وقتی CPU کاملاً مشغول نیست.
با top منشأ فشار را بررسی کنید
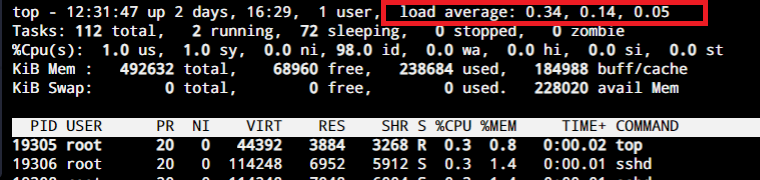
toptop نمای پویا از سیستم و فرایندها میدهد. بخش CPU، حافظه، Swap و فهرست فرایندها را کنار هم بخوانید. با کلید q خارج شوید. وضعیت wa به انتظار I/O مربوط است، ولی یک عدد بهتنهایی خرابی دیسک را اثبات نمیکند.
استفاده از htop در اوبونتو و دبیان
اگر ابزار نصب نیست و مجوز نصب بسته دارید، از مخزن رسمی توزیع استفاده کنید. دستور apt زیر مخصوص خانوادهٔ Debian و Ubuntu است و برای تمام توزیعها یکسان نیست.
sudo apt update
sudo apt install htop
htop
htop مشاهده و مرتبسازی فرایندها را آسان میکند. بالاتر بودن یک فرایند در فهرست، دلیل کافی برای بستن آن نیست؛ ممکن است همان پایگاه داده یا کار ضروری برنامه باشد. ابتدا نقش و زمان شروع مصرف را مشخص کنید.
فشار حافظه و I/O را از قلم نیندازید
اگر کرنل و محیط از PSI پشتیبانی کنند، فایلهای زیر اطلاعات فشار منابع را نشان میدهند. نبود آنها به معنی صفر بودن فشار نیست؛ ممکن است قابلیت در آن محیط ارائه نشده باشد.
cat /proc/pressure/cpu
cat /proc/pressure/memory
cat /proc/pressure/io
PSI زمان انتظار کارها بر اثر کمبود منابع را گزارش میکند. آن را با زمان کندی برنامه، لاگها و اجرای کارهایی مثل بکاپ تطبیق دهید.
چه اقدامی بعد از مشاهدهٔ بار بالا انجام دهیم؟
زمان رخداد، مقادیر بار، ظرفیت تخصیصیافته و فرایندهای پرمصرف را ثبت کنید. یک جهش کوتاه هنگام بکاپ با فشار مداوم همراه خطای کاربران متفاوت است. پیش از افزایش منابع یا توقف سرویس، گلوگاه را مشخص کنید؛ پایش بار ابزار تشخیص است، نه تضمین جلوگیری از خرابی.
مطالعهٔ مرتبط
بازبینی فنی: ۱۳ آبان ۱۴۰۵. تاریخ انتشار اولیه و نشانی قبلی حفظ شدهاند.



